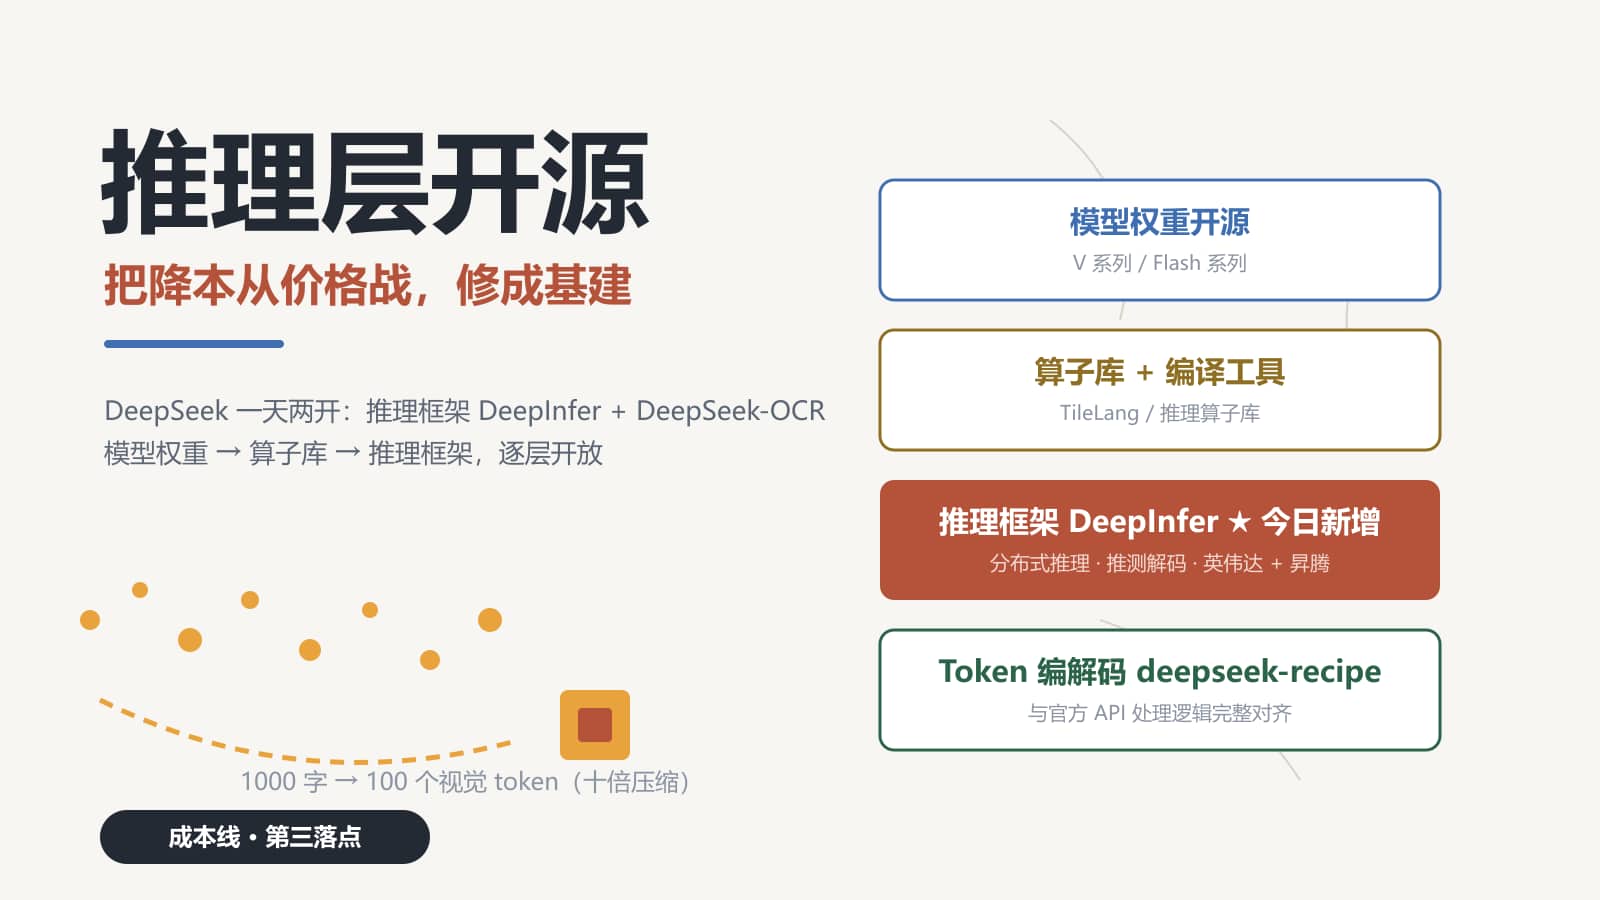
推理层开源:DeepSeek 一天两开,把降本从价格战修成基建
昨天刚写完 Flash 本位——DeepSeek、MiniMax 把价格砍到「1 元输入 / 4 元输出」,以为这轮成本战已经打到了底。今天 DeepSeek 告诉你:价格战只是结果,基建才是原因。
10 月 20 日,DeepSeek 一天之内开源了两件东西:内部推理框架 DeepInfer,和视觉-文本压缩模型 DeepSeek-OCR。前者管「跑得便宜」,后者管「输入得便宜」——两刀都砍在推理成本上,一刀都没砍在模型能力上。
DeepInfer:成本边界,由推理框架划定
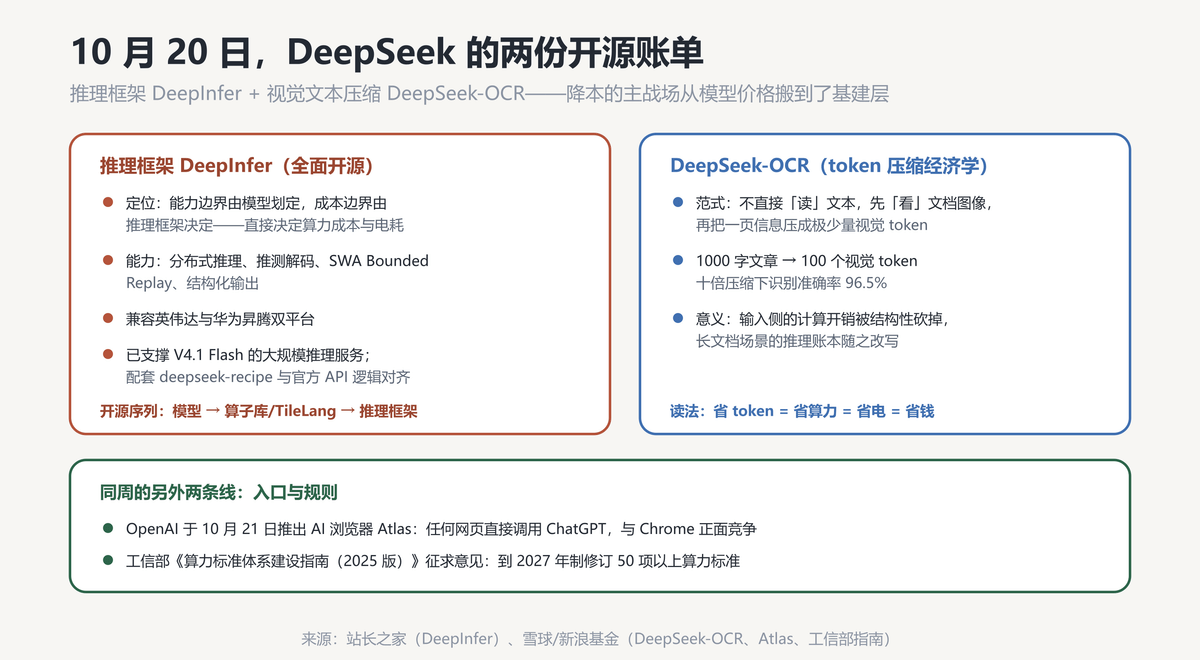
官方口径里有句话值得整段抄下来:大模型的能力边界由模型本身划定,但如何以合理成本提供超大规模模型服务,还取决于推理框架这一中间层——它统筹调度庞大的算力集群,其效率直接决定 AI 服务的算力成本与电力消耗。
翻译一下:模型是发动机,推理框架是整条动力总成。发动机再省油,传动系统漏掉一半功率,油钱照样打不住。DeepSeek 把自己的动力总成拆开给你看:分布式推理、推测解码、SWA Bounded Replay、结构化输出,兼容英伟达与华为昇腾双平台——已经支撑着 V4.1 Flash 的高吞吐低延迟大规模服务,且未来新模型的推理代码将持续在这里更新。配套同步开源的 deepseek-recipe 是生产级 Token 编解码组件,与官方 API 的处理逻辑完整对齐——社区拿到的不是阉割版,是和官方部署同一套管线。
注意这个开放序列:模型权重 → 算子库与 TileLang 编译工具 → 推理框架 → Token 编解码。一层一层往下开,开到今天,DeepSeek 的推理栈里闭源的部分已经不多了。知乎上「四大旗舰同月发布,行业为什么不卷参数了」的高赞回答给了个框架:竞争正从「比参数、比跑分」转向「比价格、比生态、比落地」——DeepInfer 是这个判断的最新注脚,而且是开源生态路线的注脚。
DeepSeek-OCR:把「读」改成「看」,输入账本改写
同一天的另一件开源更容易被低估。传统模型处理文档是直接「读」文本,DeepSeek-OCR 的思路是先「看」文本的图像,再把一页文档的图片信息高度压缩成极少量的视觉 token——一篇 1000 字的文章,压成 100 个视觉 token,十倍压缩下识别准确率 96.5%。
这对推理账本意味着什么很直白:长文档场景(合同审阅、试卷批改、档案数字化)过去是 token 大户,现在输入侧开销被结构性砍掉一个数量级。省 token = 省算力 = 省电 = 省钱——这条等式链,就是昨天 Flash 价格战的物理基础。
昨天卷价格,今天卷基建,明天呢
把两天的新闻摆在一起看,一条线出来了:
- 价格层(10.17–10.19):Flash 本位,模型报价集体跳水;
- 基建层(10.20):推理框架开源,降本能力本身成了公共品;
- 入口层(10.21):OpenAI 推出 AI 浏览器 Atlas,任何网页直接调用 ChatGPT,与 Chrome 正面竞争——奥尔特曼的原话是「AI 代表着十年一遇的机会,让人们重新思考浏览器应当是什么」;
- 规则层(同步):工信部《算力标准体系建设指南(2025 版)》征求意见,到 2027 年制修订 50 项以上算力标准。
四层各动各的,但指向同一件事:智能的单位成本正在全栈下降。DeepSeek 的打法尤其值得琢磨——把降本做成开源基建,护城河就从「我便宜」变成「我的便宜别人抄不动」:你抄我的价格,抄不走我整套优化过的推理栈;而每一个基于 DeepInfer 做私有化部署的团队,都在替这条技术路线打工(贡献优化、反馈场景、培养生态)。这是云厂商战略里「卖水电不卖发电机」的开源版。
英伟达 + 昇腾双平台兼容这条也别放过——国产算力上跑大模型的工程门槛,今天又被实质性降低了一格。
别急着全押
其一,推理框架开源不等于免费午餐——分布式推理的调度、运维、故障恢复的工程门槛仍在,中小企业真能「白嫖」的更多是 deepseek-recipe 这类组件,完整吃下 DeepInfer 需要一支像样的基础设施团队;其二,96.5% 准确率是特定基准口径,复杂版式(表格嵌套、手写混排、多栏公式)下的边界没有公开数据,落地前先拿自己的脏数据测;其三,框架性能的官方表述(「高吞吐、低延迟」)尚无第三方复测,参照本栏惯例:等两周,看真实部署的数字。
写在最后
对做私有化部署的同行,今天的意义很具体:昇腾 + DeepInfer + deepseek-recipe 的组合,让国产算力私有化推理从「政治正确」变成了「工程可选」——成本模型第一次能和公有云 API 正面算账。拿我们在做的场景举例,学校实训平台要在本地跑批量阅卷和文档处理的实验,过去只能排队调云端 API,现在这套开源栈给了端到端的参照实现——这学期给学生布置的推理部署作业,正好有了现成的教材。
参考来源
- 站长之家:DeepSeek 开源推理框架 DeepInfer——推理成本成为 AI 普惠的关键一层
- 雪球(新浪基金):DeepSeek 开源 DeepSeek-OCR 视觉-文本压缩范式,1000 字压成 100 个视觉 token、准确率 96.5%;OpenAI 推出 AI 浏览器 Atlas;工信部算力标准指南征求意见
- 知乎:如何评价 2026 年 10 月四大旗舰大模型同月发布——从比参数转向比价格、比生态、比落地
- 知乎(AI 前线 10.20):Qwen 本地新模型传闻、Gemini 4 Carbon 订档、Anthropic Fable 5.5 将至、GPT-6.1 Terra 现身
- Flash 本位与 Haiku/Luna 地板价:见本博《Flash 本位》《界面长出来、价格钉在同一分钱》各篇参考来源