榜单让位给账单:Qwen4-Max 全量、混元 Hy4 flash 同日亮牌——考分涨了 28%、思考量少了一半,大模型进入「单任务成本」时代
11 月 16 日是个双发日。阿里巴巴发布新一代基座大模型 Qwen4-Max——2.4T 总参数、71B 激活;腾讯混元推出 Hy4 flash——224B 总参数、12B 激活、1M 上下文。一个用 2.4T 去够智能天花板,一个用 12B 激活把成本压到前代的二十分之一。
对追更的读者先交代一句:五天前本栏写过 Qwen4-Max 预览版「先上车,后补票」——今天,补票来了,全量上线,价目表也一并挂出。
Qwen4-Max 的账本:一半思考量,更高考试分
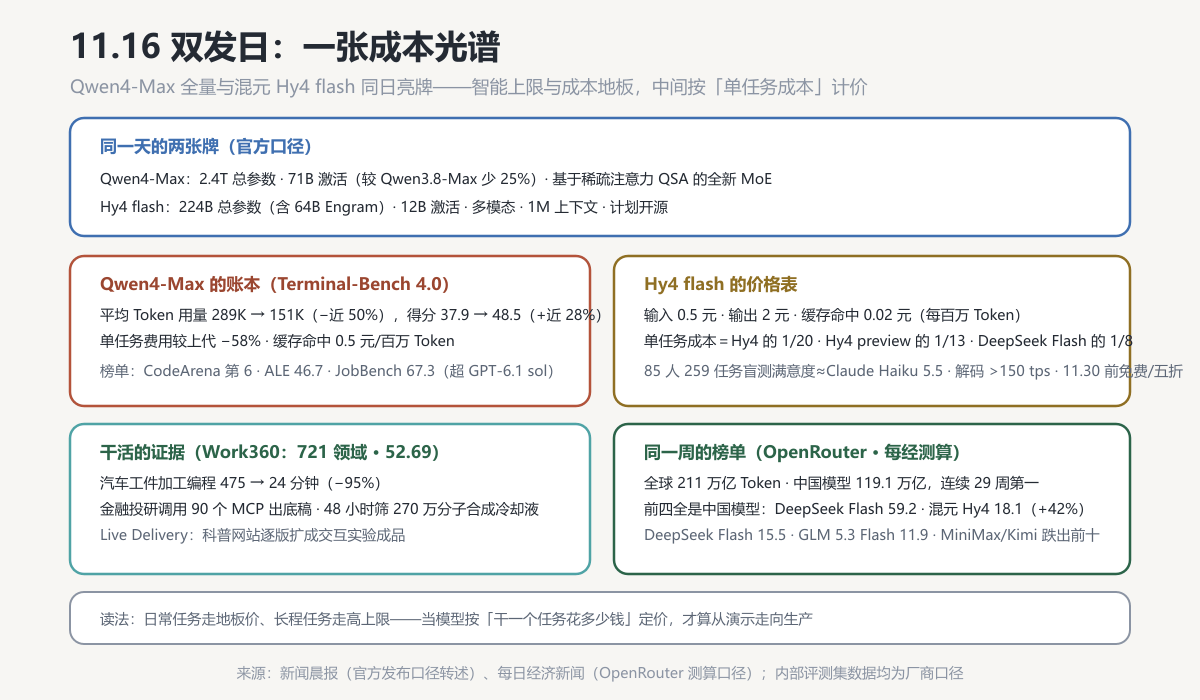
这份账本里最反直觉的一组数字来自 Terminal-Bench 4.0(同为 Xhigh 思考档位):**每次尝试的平均 Token 用量从上代的 289K 降到 151K,减少近一半;得分却从 37.9 升到 48.5,提升近 28%。**用更少的 Token 干更重的活——这不是补贴出来的降价,是基于 Qwen 稀疏注意力(QSA)的全新 MoE 架构与训练效率的直接结果,每个 Token 激活的参数比 Qwen3.8-Max 少了 25%,性能没有让步。
费用随之落地:完成单任务的平均费用较上代降低 58%,缓存命中价格低至每百万 Token 0.5 元。
榜单也没有缺席:CodeArena 前端编程全球盲测第 6,位于 GPT6-Astra 和 Claude Fable5.1 之间,刷新中国模型最好成绩;Agents’ Last Exam 46.7 分(较上代提升 18.8);JobBench 67.3,超过 GPT-6.1 sol。多个维度同时进第一梯队,不是单项冒尖。
干活的证据:从 475 分钟到 24 分钟
比榜单更有说服力的是真实任务。千问团队构建了覆盖 721 个细分领域的 Work360 全场景评测,Qwen4-Max 得分 52.69、较上代提升超 10%。几个具体场景值得抄录:
- 汽车制造:单个工件加工编程的人工用时从 475 分钟降到 24 分钟,减少 95%;
- 金融投研:调用 90 个 MCP 专业工具,产出 Excel 底稿与 PPT 报告;
- 材料发现:连续 48 小时自主运行,从 270 万个候选分子中筛选并真实合成出一种新型冷却液材料;
- Live Delivery 持续交付:先给可用首版,再按反馈逐版扩展——一个物理课堂科普网站最终被扩成带 3D 动画和交互实验的成品。
48 小时自主运行那一项的门槛最高:长程任务里任何一步出错都会前功尽弃,它考验的不是单次推理,是可靠性。
Hy4 flash:把日常任务打到地板价
腾讯的路数更极端。Hy4 flash 总参数 224B(含 64B Engram 参数),激活只有 12B;价格表直接挂在脸上:**输入每百万 Token 0.5 元、输出 2 元,缓存命中输入仅 0.02 元。**在腾讯内部 WorkIndex 评测上,Hy4 flash 单任务成本是 Hy4 的 1/20、Hy4 preview 的 1/13、DeepSeek-V4.1-Flash 的 1/8。
地板价背后是一整套工程组合拳:KV cache 大小仅为 Hy3 的 1/24、Hy4 的 1/6;后训练用自蒸馏从 Hy4 获得综合智能,再用强化学习把端到端输出长度砍了一半;推理侧叠加 megakernel、4bit 量化、DFly,解码速度超过 150 tps。结果是综合效果略优于参数大得多的 Hy4 preview(770B 总参数、49B 激活),成本却显著更低。
它的评测方式也值得注意:腾讯没把重心放在公开榜单,而是用 85 位内部用户对 27 类共 259 个任务盲测——任务端到端时长最短,满意度接近 Claude Haiku 5.5。定位说得很直白:PPT、文档、表格、深度搜索这些日常任务用 flash,长程软件工程再交给智能上限更高的 Hy4。11 月 30 日前 WorkBuddy 限时免费、API 五折,并且计划开源。
同一周的榜单:便宜的在接管流量
把镜头拉到同一周的 OpenRouter 榜单(每经测算口径),背景音更响:**上周全球大模型总调用量 211 万亿 Token,中国模型 119.1 万亿、连续二十九周超过美国稳居第一;调用量前四名全部是中国模型——DeepSeek V4.1-Flash-1017 以 59.2 万亿连续四周第一,腾讯混元 Hy4 升至第二(18.1 万亿,环比增长 42%),DeepSeek V4.1-Flash 第三,智谱 GLM 5.3 Flash 第四。**此前在前十的 MiniMax M3.1 Flash 与 Kimi K3.1 Pro 双双跌出。
注意一个规律:调用量榜前四名里,除了混元 Hy4,其余三席全是 Flash 系。调用量榜从来不是能力榜,是价格榜——谁便宜,谁的流量就多。混元 Hy4(11 月 4 日发布)发布后的第一个完整周就冲到第二,靠的正是这套成本打法;而 Hy4 flash 是把同一打法再往下打一层。
计价说明
其一,Qwen4-Max 的 289K→151K、-58%、475 分钟→24 分钟均为官方口径,评测场景与基线以官方文档为准,第三方实测待铺开;其二,Work360、WorkIndex 均为厂商内部评测集,「满意度接近 Claude Haiku 5.5」出自腾讯内部 85 人盲测,非公开基准;其三,OpenRouter 数据为《每日经济新闻》测算口径,只反映该聚合平台的调用量,不等于全行业用量;其四,0.5 元、0.02 元为缓存命中价,五折与免费为 11 月 30 日前限时政策。方向不掺水:两条路线拼成一条完整的成本光谱——日常任务走地板价,长程任务走高上限,中间按「干一个任务花多少钱」计价。我们给学校做 AI 助教与知识库选型时,预算表上早就是这个算法:先算单任务成本,再谈模型名字。当全行业都开始这样算账,大模型才算真正从演示走向生产。
参考来源
- 新闻晨报(网易号):阿里腾讯的大模型同日「亮剑」,一个冲智能上限,一个拼极致性价比(Qwen4-Max 架构与 Terminal-Bench 数据、榜单成绩、Work360 场景案例、Hy4 flash 价格与工程细节、WorkIndex 盲测全文)
- 每日经济新闻(腾讯新闻):全球 AI 大模型周调用量榜单出炉——前四名被中国模型包揽,腾讯混元 Hy4 冲进前二,MiniMax、Kimi 跌出 Top10(OpenRouter 数据:211 万亿总量、中国 119.1 万亿、连续 29 周第一、各模型位次与环比)
- 本栏前作《OpenAI 的模型还卡在安全审查里,阿里的预览版已经挂上货架:Qwen4 开门抢测、票价一折——先上车,后补票》(2026-11-12,预览版发布背景)