评审墙:代码多了三成,活只多了一成——AI 编程的产能,消失在写代码之外
昨天写了验证成本——个体开发者每周省下 13 小时、又被审查吃回去一半。今天这组数字把镜头拉到团队层面,结论更扎心:AI 编程的产能,大量消失在写代码之外。
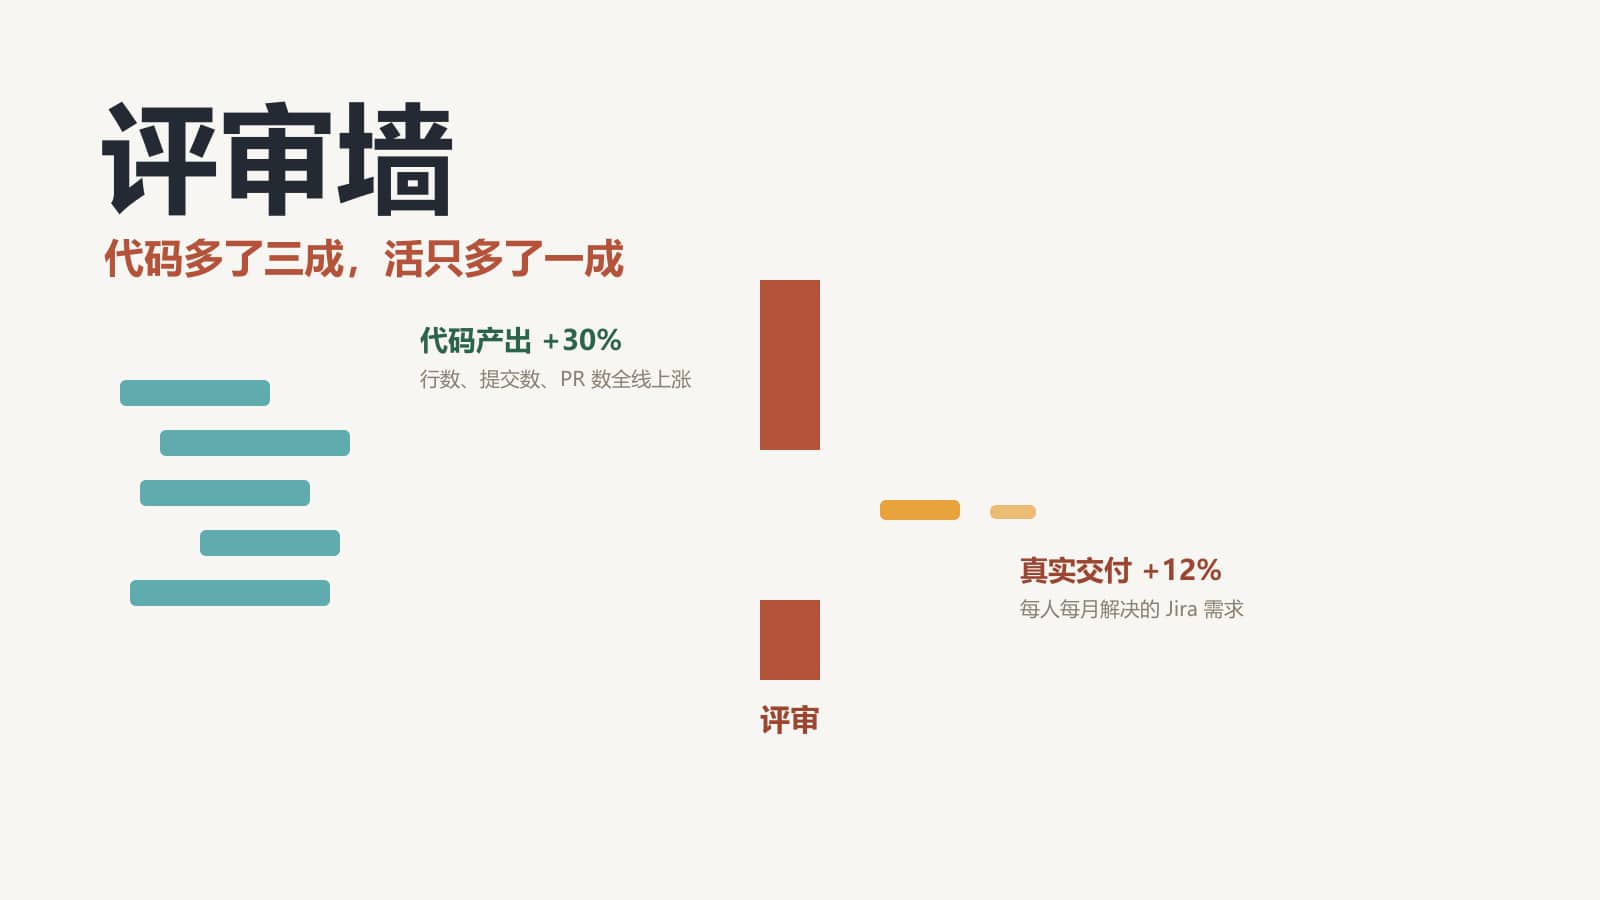
被广泛转述的一组工程效能研究数字是这样的:引入 AI 之后,代码行数、提交数、PR 数量显著上涨,AI Agent 组的代码产出涨了约 30%。但当研究者换一把尺子——用「每人每月解决了多少个 Jira 需求」来衡量真实交付——数字立刻塌缩:AI 助手组几乎没有带来需求解决数的增长,AI Agent 组也只提升了约 12%。
写出来的代码多了 30%,真正被验收、合并、上线、解决了业务问题的工作,只多了 12%。中间那 18 个点,去哪了?
答案是一堵墙
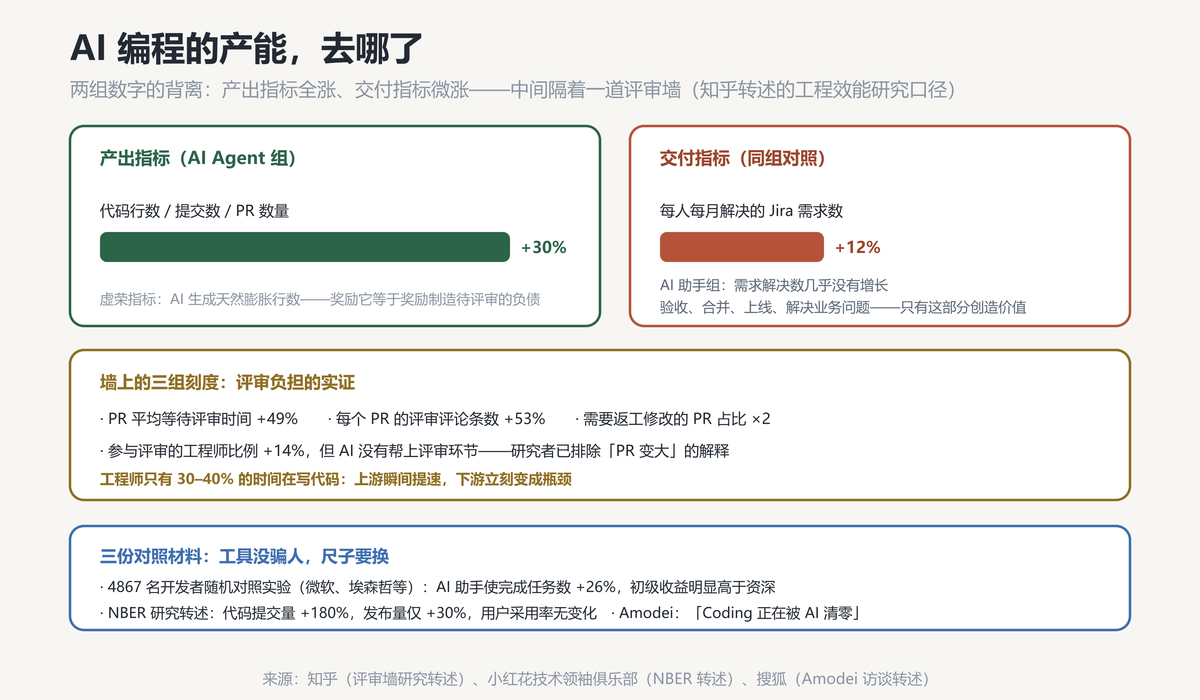
研究者往下挖,发现产能卡在「评审」这个窄口上。三组数字:**PR 平均等待评审的时间 +49%;每个 PR 的评审评论条数 +53%;需要返工修改的 PR 占比直接翻倍。**更尴尬的是,参与评审的工程师比例上升了 14%,但 AI 并没有帮上评审环节——评审者读 AI 生成的代码,要花更多时间去理解、去怀疑、去找藏在背后的幻觉。研究者特意排除了一个偷懒的解释:「PR 变大了」——平均每个 PR 的体积并没有显著增加,评审负担就是实打实加重了。
结构性原因一句话就能讲清:工程师本来就只把 30%–40% 的时间花在写代码上,剩下的时间在做需求梳理、代码评审、测试、部署。AI 把「写」这个环节瞬间拉快,整条流水线的速度就被下游最慢的环节锁死了——瓶颈不在上游,瓶颈从来都在墙上。
Reddit 上被大量点赞的一条评论值得抄下来:「每一行代码都是一份潜在负债。」AI 写得越快,评审者要吞下去的负债就越多。另一条评论的预测更狠:未来衡量 AI 编程工具的关键指标,可能不再是「写了多少代码」,而是故障恢复时间(MTTR)——因为越来越多工程师,对自己上线的代码其实并没有完整理解。
工具没有骗人,尺子错了
先别急着否定 AI 编程。同一天能看到的另一份材料是覆盖微软、埃森哲等 4867 名开发者的随机对照实验:使用 AI 编程助手让完成任务数提升了约 26%,而且初级开发者的收益明显高于资深工程师——AI 确实在抹平入门门槛。NBER 研究的转述版本则是:代码提交量 +180%,发布量仅 +30%,用户采用率无变化。
三份材料放在一起,结论不是「AI 没用」,而是:**用产出量衡量 AI 的效果,本身就是错的度量。**团队如果还在用行数、提交数、PR 数考核研发效能,等于在奖励 AI「制造」更多需要被评审和返工的代码——指标会好看,交付不会。
Amodei 本周那句刷屏的「Coding 正在被 AI 一键清零、程序员将集体转岗」也需要放在这把尺子下读:被清零的是「写」这个动作,不是工程师这个岗位——NBER 的岗位预测口径是软件开发者岗位 +15.8%、传统程序员岗位 −6%,角色在重构,总量没有塌方。顺带一句,说这话的人家正在卖最强的编程模型,立场要打折扣听。
换尺子的三个动作
给技术管理者的建议,昨天给过个体版,今天给组织版:
其一,考核指标从产出量切换到交付量——每人每月解决的需求点数、发布频次、MTTR,行数和 PR 数从 KPI 里删掉;其二,把评审计入产能:评审等待 +49% 意味着评审者是新的瓶颈资源,给他们留出整块时间、在排期里显式计价,而不是当成写码之余的免费劳动;其三,按交付验收 AI:选型时别看演示里生成得多快,看三个硬指标——生成的代码是否易读、幻觉率多高、能不能自动补测试。这三件事直接决定你的团队要不要在评审环节集体加班。
我们这学期给实训课改评分标准就是这个逻辑:以前数代码量和提交次数,现在按「交付并通过互审的需求点数」计分——学生交付慢了一点,但互审时找出的缺陷数翻了一倍,这才是能带去岗位上的能力。
冷水与边界
其一,今天引用的核心研究以知乎转述口径流传,原始研究机构与样本量未具名,三组评审数字方向可信、精度存疑,引用时建议标注;其二,NBER 的 +180%/+30% 同样来自二手转述,未核对原论文;其三,4867 人实验测的是「完成任务数」,它和「业务价值」之间还隔着产品决策的距离——尺子没有完美的,只有不那么骗人的。
但趋势已经足够清楚:**AI 编程的下一个战场不在生成端,在评审端。**谁先把评审这个窄口拓宽——更好的 AI 自检、更可靠的测试生成、更诚实的幻觉标注——谁就拿到了那消失的 18 个点。对开发者个人,昨天说过的结论再强调一遍:生成代码的边际成本趋近于零之后,值钱的是判断,不是产出。
参考来源