Flash 本位:DeepSeek、MiniMax 同周亮牌,大模型竞争的重心从「更聪明」搬到了「更快更便宜」
一周之内,国产大模型的两家头部厂商干了同一件事:把 Flash 模型当成了发布会的主角。
10 月 17 日清晨,DeepSeek 发布 V4.1 Flash-1017,网页端、App、API 三端同步切换——不是灰度、不是预约,直接把默认入口换成了轻量版。两天后的 10 月 19 日,MiniMax 发布新一代 M3.1 Flash。最值得玩味的细节是:MiniMax 在同一场官宣里只把「追求智能上限的 Pro 版本」放在了预告位置。
**旗舰成了选配,Flash 成了本位。**这个次序的颠倒,比任何一个跑分都更能说明行业重心搬到了哪里。
两张账单
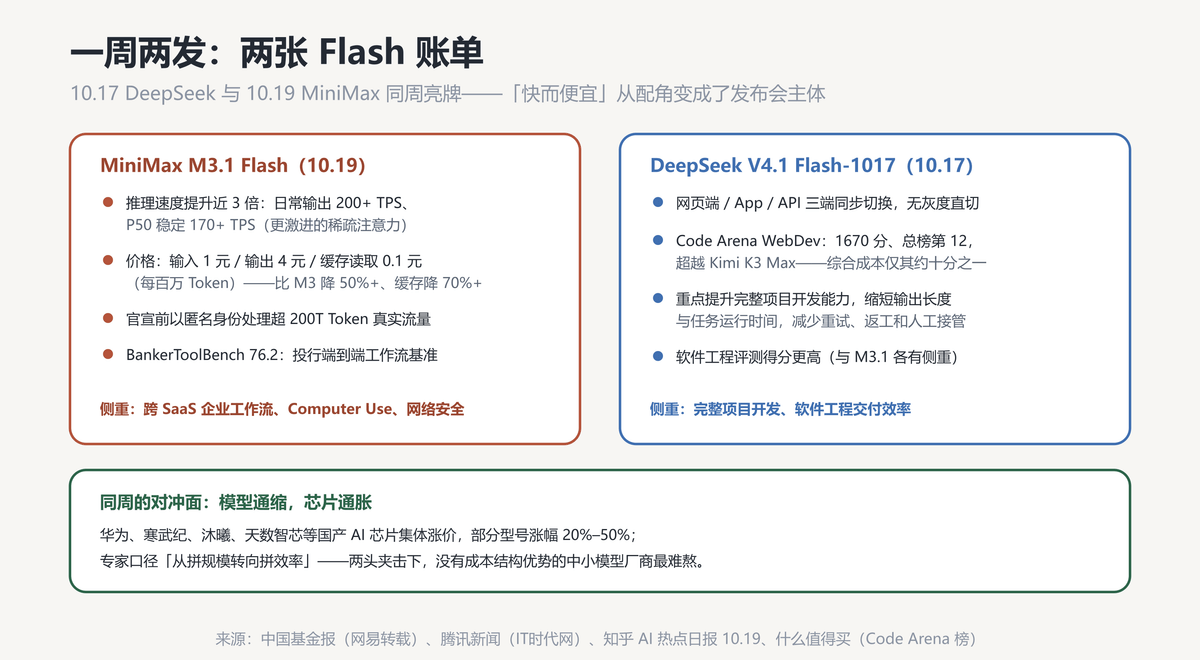
MiniMax M3.1 Flash 的账:线上推理速度提升近 3 倍——靠更激进的稀疏注意力架构,日常输出 200+ TPS、P50 稳定 170+ TPS;价格降到输入 1 元、输出 4 元每百万 Token,缓存读取只要 0.1 元,对比 M3 输入输出单价降了一半以上、缓存读取降超 70%;能力侧主打 Agentic 任务、Computer Use、跨 SaaS 企业工作流(销售到 HR 全链路)和网络安全,投行端到端工作流基准 BankerToolBench 拿了 76.2 分。还有一个此前被当花边讲的注脚:官宣之前,它以匿名身份处理了超过 200T Token 的真实流量——发布的,就是已经被真实流量锤过的那个模型。
DeepSeek V4.1 Flash-1017 的账:三端直切、无灰度;Code Arena 的 WebDev 代码榜 1670 分、总榜第 12,把 Kimi K3 Max 挤下了开源头名——终结了后者近三个月的第一梯队停留,而综合成本只有它的约十分之一;重点提升完整项目开发能力,思路是缩短输出长度和任务运行时间,减少重试、返工和人工接管。
中国基金报把这总结成一句话,值得抄下来:**模型竞争已经延伸到「完整任务的交付效率」——能力、速度、成本同步改善,才可能把任务推进高频使用阶段。**翻译成工程话术:拼的不再是单次对话多惊艳,而是「一单活儿干到底,总共烧几个钱、几分钟」。
这是「智能体经济学」的国产落地
本栏 10 月初写过:Haiku 5.5 与 GPT-6 Luna 一周之内、各自独立地把小模型价格钉在输入 0.10 美元/输出 0.50 美元的同一地板上——当两家独立算出同一个数字,那不是巧合,是地板。这周发生的事是同一逻辑的国产版,且更激进:海外还是「旗舰 + 子智能体」的分层结构,国产两强直接把 Flash 顶到了默认入口的位置。
分层还是本位,差别很大。分层意味着旗舰仍是产品心智的中心;本位意味着厂商承认——绝大多数日常流量,就该由轻快便宜的那一档来承接。这不是技术妥协,是商业模式选择:当 Agent 从「偶尔问问」变成「全天候替你干活」,单位任务成本就是生死线。
顺带一提发布范式的变化:先匿名上线吃真实流量、再官宣认领,200T Token 就是投名状。跑分发布会正在让位给跑量发布会——榜单可以刷,两周的匿名全网压测刷不了。给政企校做选型的同行提个醒:看模型,先看它敢不敢匿名上线。
模型通缩,芯片通胀
但把镜头拉远一点,同一周还有一条反向的新闻:华为、寒武纪、沐曦、天数智芯等国产 AI 芯片厂商集体涨价,部分型号涨幅 20%–50%,专家口径是「AI 产业竞争应从拼规模转向拼效率」。
两头一起读就有意思了:模型端在通缩(价格三个月砍一半以上),芯片端在通胀(一年涨两到五成)——这把剪刀差,剪掉的正是中间没有成本结构优势的中小模型厂商。上个月刚在开源榜上亮牌的新势力们,撞上的就是这个地板:Flash 本位时代,「比头部便宜」这个定位本身正在失效,因为头部自己正在变得更便宜。
三句清醒话
其一,「速度提升近 3 倍」「成本降 70%」都是厂商官方口径,第三方复测(尤其真实工作流下的 P50 延迟)还没跟上;其二,Flash 的天花板问题没有消失——M3.1 的 Pro、追求智能上限的那条线还没交卷,复杂推理任务上旗舰与轻量版的差距仍在,别用一个 Flash 解决所有问题;其三,两家的侧重其实不同(DeepSeek 软件工程更强、M3.1 跨 SaaS 与安全更突出),按任务选模型、别一棵树上吊死,是当下最务实的姿势。
写在最后
给同行的选型建议更新一版:默认档切到 Flash 级,旗舰按需调用——这不再是省钱技巧,是行业自己选出来的默认值。拿我们自己的场景举例:学校实训课上几十个学生并发跑 Agent 项目,用旗舰模型的算力账根本没法看,切到「1 元输入 / 4 元输出」这一档,一学期的预算第一次算得过来——这两个月帮几家学校做的实训算力方案,账面差异都是数量级级别的。
参考来源
- 网易(中国基金报):DeepSeek、MiniMax 出手,国产 AI 大模型「新战场」来了——Flash 定价与交付效率框架
- 腾讯新闻(IT时代网):MiniMax M3.1 Flash 大模型正式发布,推理速度提升近 3 倍——含匿名 200T Token 细节
- 知乎(AI 热点日报 10.19):DeepSeek V4.1-Flash 三端落地、国产十万卡超集群亮相、Meta 开源 816B、国产 AI 芯片涨价 20%–50%
- 什么值得买:Kimi K3 Max 代码榜实测——V4.1-Flash-1017 以 1670 分列总榜第 12、成本约其十分之一
- 什么值得买:比 DS V4.1 Flash-1017 更强更便宜,又一款国产 AI 今天发布
- 搜狐:MiniMax 发布 M3.1 Flash——推理快 3 倍、成本直降 70% 的效率革命
- 搜狐:DeepSeek V4.1 Flash 重磅升级,AI 编程新纪元来临