手机芯片也玩超线程了:麒麟 9050 灵犀 CPU 官方详解——9 核 16 线程、内存多 3GB,被制裁逼出来的「架构补工艺」
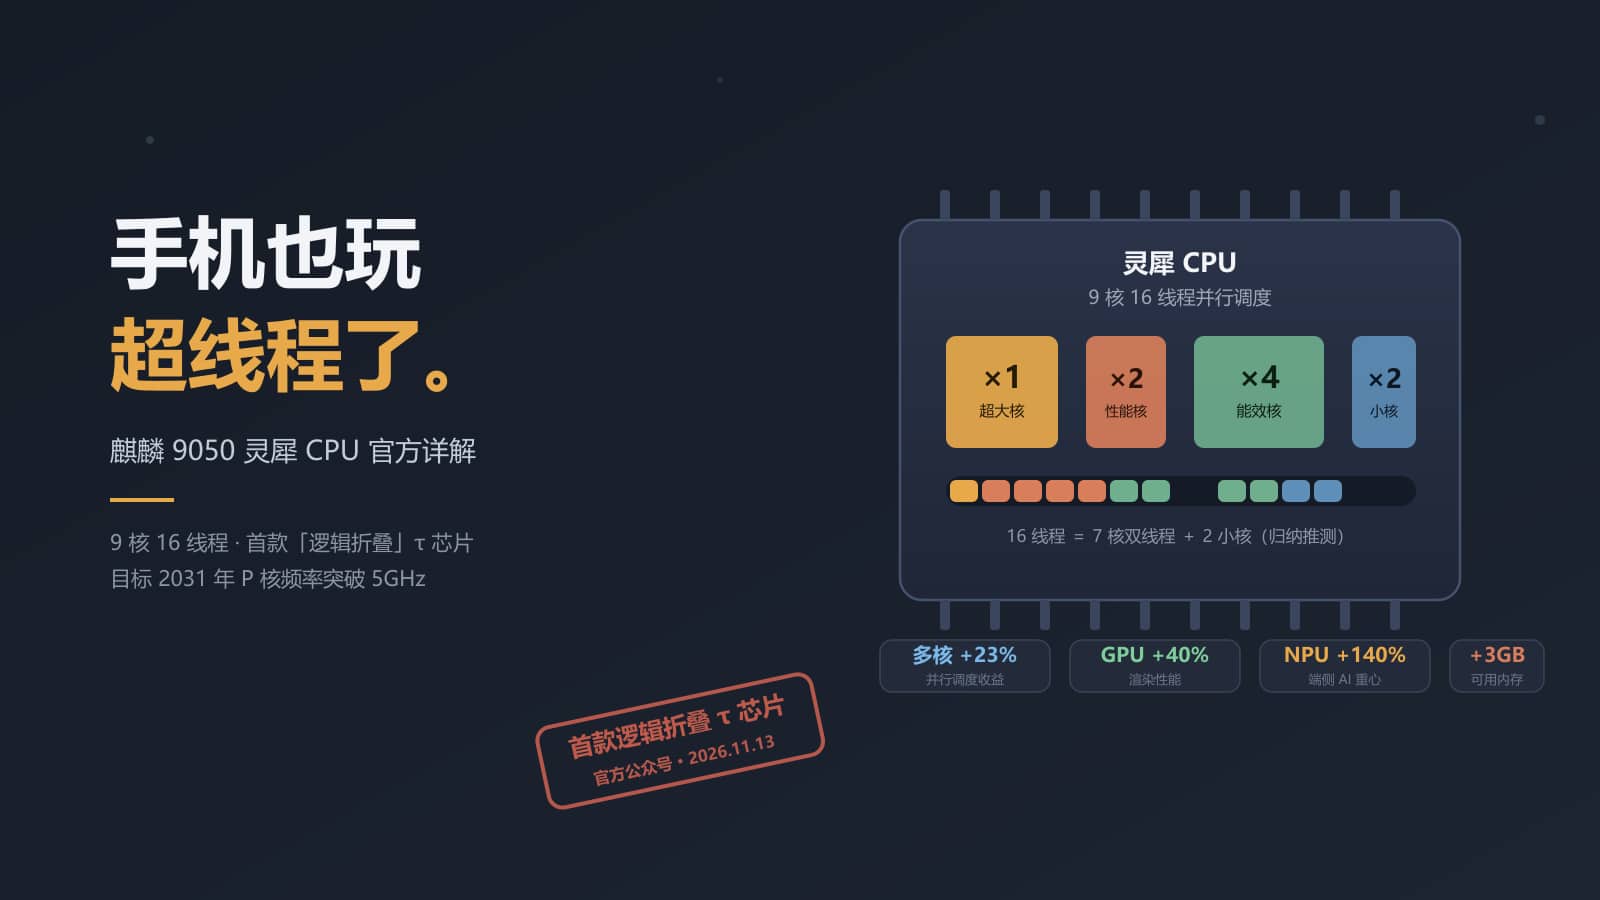
「超线程」这个词,二十多年来基本属于桌面和服务器 CPU。11 月 13 日深夜,华为麒麟官方公众号公开了麒麟 9050 系列新一代灵犀 CPU 的详细信息——9 核 16 线程并行调度,超线程第一次出现在手机 SoC 上。
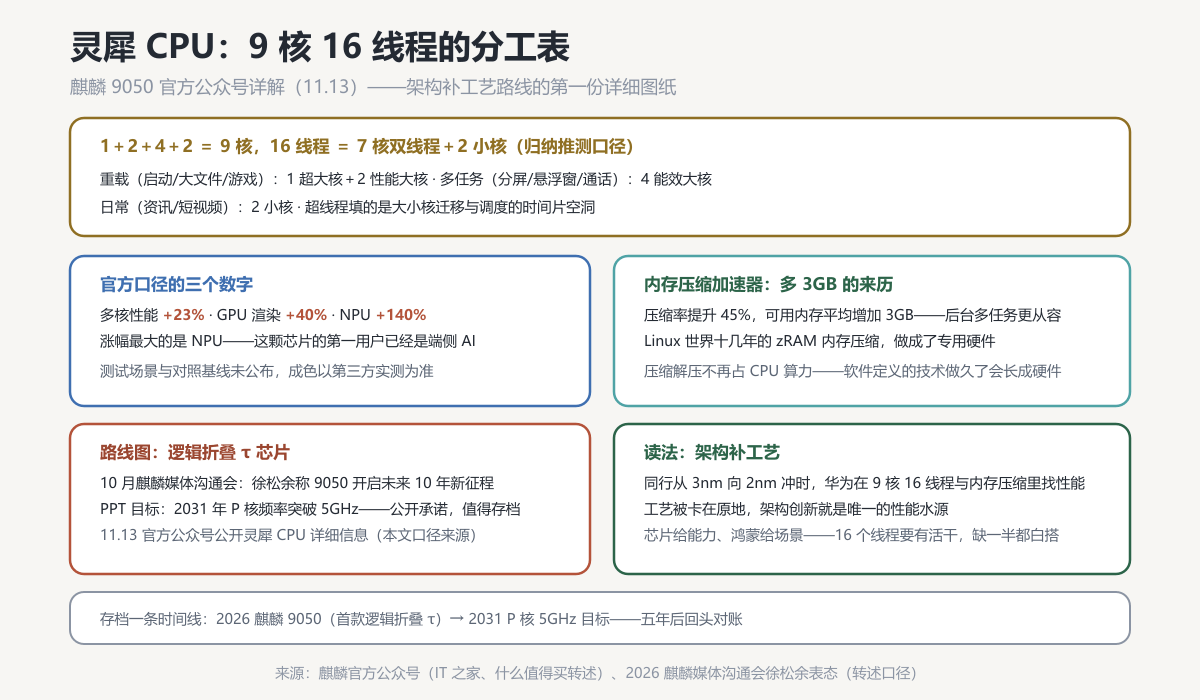
官方口径的三个数字:**多核性能提升 23%、GPU 渲染性能提升 40%、NPU 性能提升 140%。**涨幅最大的是 NPU,重心不言自明——这颗芯片的第一用户已经是端侧 AI。
1+2+4+2:一张分工表
官方把 9 个核心的分工写得很清楚,这是整份公开里最有信息量的部分:
- 重载场景(应用启动、大文件加载、游戏运行):1 超大核+2 性能大核
- 多任务场景(UX 交互、悬浮窗、视频通话、分屏):4 能效大核
- 日常场景(浏览资讯、短视频):2 小核
1+2+4+2=9 核。**16 线程减 9 核等于 7——按公开信息归纳(推测口径),是 7 个核心支持双线程,最可能的组合是超大核、性能大核与能效大核全部开启 SMT,2 个小核保持单线程。**华为没有明说哪 7 个核超线程,这个推断留给后续实测验证。
为什么手机现在需要超线程?桌面 CPU 的 SMT 是为了让一个物理核在等内存、等分支预测的空档里跑第二个线程——手机大小核架构里,这个空档同样存在,而且更碎:任务在大小核之间迁移有时间片损耗,能效核接过交互任务时常常「吃不饱」。超线程填的正是这些调度空洞:与其让核心闲着,不如让线程冗余顶上。配合鸿蒙的应用并行化与智能调度,这 16 个线程才有活干——芯片给能力,操作系统给场景,缺一半都白搭。
内存多 3GB:zRAM 的硬件化
另一个被低估的细节是内存压缩加速器:压缩率提升 45%,可用内存平均增加 3GB。
玩过 Linux 和 OpenWrt 的人对这套思路不陌生——zRAM 内存压缩存在十几年了,把不活跃的内存页压缩后塞回内存里换可用空间,代价是 CPU 要花算力做压缩解压。手机厂商的「内存扩展」「融合内存」本质都是它。麒麟 9050 的做法是把压缩做成专用硬件加速器:压缩解压不再占 CPU 算力,后台多任务「更从容」这句话才成立。软件定义的老技术,做得够久,最终都会长成硬件——这是芯片行业反复上演的剧本。
官方还提到智能异构调度提升续航、硬化低时延调度让 XPU 协同更高效——CPU、GPU、NPU 之间的调度正在从操作系统层下沉到硬件层,方向与行业一致。
为什么是现在:架构补工艺
把时间线拉长看这次的背景。今年 10 月的 2026 麒麟媒体沟通会上,华为半导体业务无线终端芯片产品管理部部长徐松余说,麒麟 9050 系列作为首款「逻辑折叠」的 τ 芯片,「将开启未来 10 年新征程」,PPT 上写着目标 2031 年 P 核频率突破 5GHz。
「逻辑折叠」的具体实现华为没有公开细节,但从命名和节奏看,这是在工艺受限的约束下,用芯片架构与设计方法的创新去补先进制程的缺口。这次的 9 核 16 线程、内存压缩加速器,都是同一条路线上的具体动作:**当制程被卡在原地,频率和密度涨不动,架构就成了唯一的性能水源。**全球同行在 3nm 往 2nm 冲的时候,华为在 1+2+4+2 和超线程里找性能——两条路都没错,只是约束条件不同。2031 年 P 核 5GHz 是个值得存档的公开承诺,五年后回头对账。
给做国产化适配的同行一个提醒:鸿蒙 PC 与擎云系列已把国产化率卷到 100% 认证,移动端 SoC 的架构文档也在越放越细——给高校做国产化环境适配的功课,又多了一章。
读芯须知
其一,23%、40%、140%、45%、3GB 均为华为官方公众号口径,测试场景与对照基线未公布,成色以第三方实测为准;其二,「7 核双线程+2 小核单线程」是按公开信息归纳的推测口径,官方未确认具体分配;其三,「逻辑折叠」技术细节未公开,本文只讨论其路线意义;其四,NPU 提升 140% 的基准口径同样未公布,端侧 AI 的实际收益等真机。方向不掺水:这颗芯片真正值得记的不是某个百分比,而是它证明了一件事——被卡住工艺的一方,会把架构创新卷到极限。
参考来源